
做数字货币必须搞懂:区块数据存储在哪、怎么防丢、能撑多久?
干了八年区块链底层数字货币区块数据存储,最常被问的一句话就是"你们那些区块数据到底存在哪儿"。说实话,这个问题看着简单,背后牵一发动全身。每一笔交易上链后,数据要经过打包、验证、写入、同步一整套流程,整个网络的存储结构直接决定了链的寿命。
数据存在哪?最直接的答案:存满每个全节点。以比特币为例,一个全节点要跑完整条链,现在体量已经逼近四百GB。以太坊更夸张,加上状态根、收据,节点磁盘占用早就破千。轻节点只存块头加Merkle证明做数字货币必须搞懂:区块数据存储在哪、怎么防丢、能撑多久?,体积能压到几MB,代价是信任假设更重。
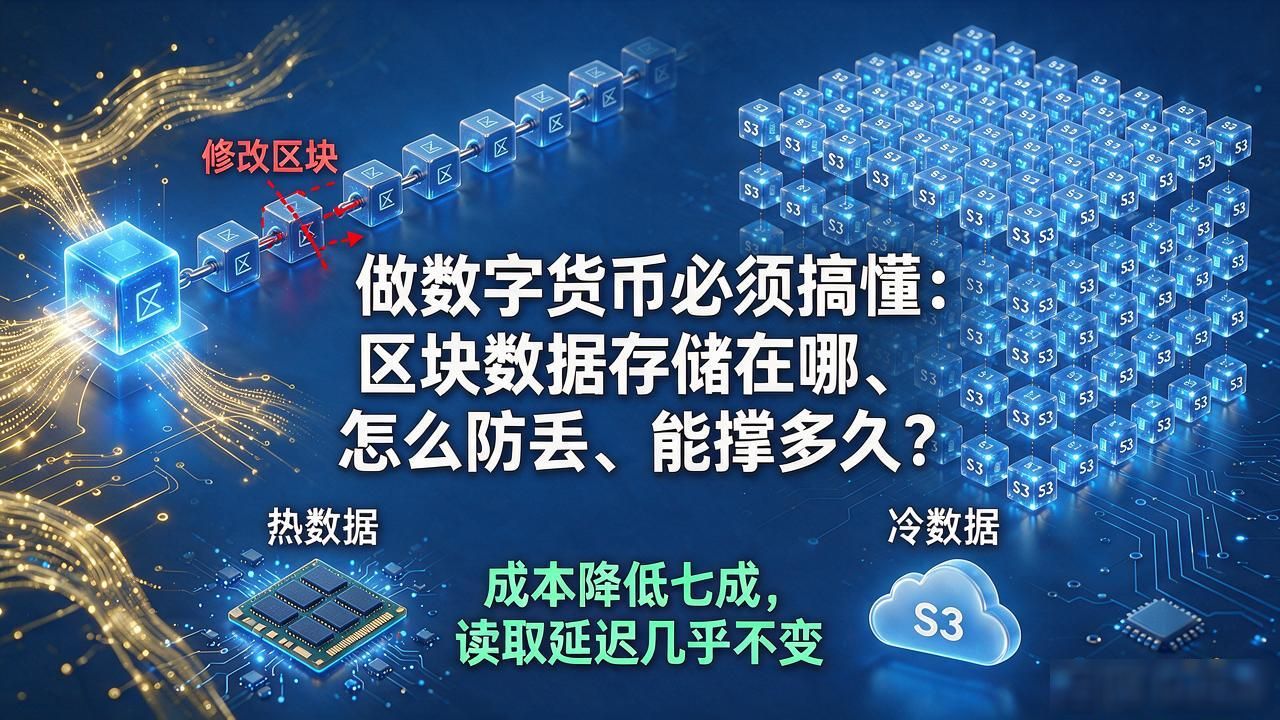
怎么防丢?核心靠两点。一是共识机制保证数据不可篡改,改一笔就要重写后面所有块,算力成本大到不现实。二是数据天然冗余,几千个节点各存一份,单点炸了不伤筋动骨。我见过一个团队做分片存储,把历史区块冷热分离,热数据放SSD、冷数据扔S3,成本砍了七成,读取延迟几乎没变。
瓶颈摆在那儿。链越长,全节点同步越慢,新节点入网得拉几小时甚至几天的历史数据。以太坊搞分片、rollup把计算推上链外,本质都是在给存储做减法。我判断,未来三年存储层最大的变量不是硬盘价格,而是数据上链量级的指数膨胀,谁先把归档和可检索性做对,谁就握住下一轮的入口。
你平时用钱包或者链上工具,有没有注意过自己其实只碰到了冰山一角?下次打开浏览器查个交易哈希,背后有多少节点在同时为你调取、验证、回放数据,大概率没人跟你说过。